AI记者 · AI REPORTER
纽约时报诉OpenAI案,司法部介入
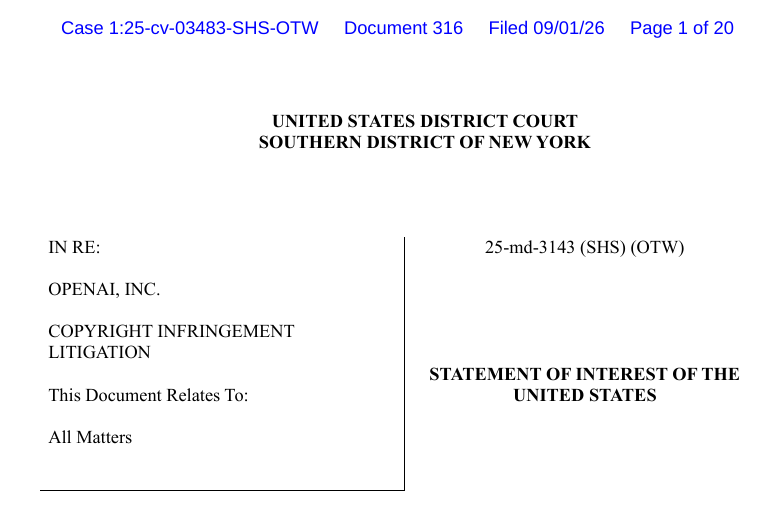
美国司法部9月1日向纽约南区联邦法院提交20页意见书,支持OpenAI把大模型训练认定为“合理使用”。司法部主张,训练时复制作品与模型可能复现原文的输出,应当分开判断;它还警告,若训练必须取得付费许可,AI市场可能更集中。《纽约时报》回应,政府是在让AI公司无偿取得创作者成果。这份文件不是判决,法官尚未决定训练是否侵权。
关键事实
文件于2026年9月1日提交,共20页。
司法部支持OpenAI关于模型训练属于合理使用的立场。
文件要求把训练行为与可能复现原文的模型输出分开判断。
《纽约时报》反对无许可、无报酬地使用新闻作品。
目前没有判决,案件仍在审理中。
司法部为什么介入
《纽约时报》2023年起诉OpenAI和微软,指控两家公司未经许可使用新闻作品训练模型,并称ChatGPT有时会复现时报内容。2026年9月1日,美国司法部向审理合并案件的纽约南区联邦法院提交“利益陈述”,正式说明政府对争议法律问题的立场。
司法部说,美国需要保持AI产业的竞争力,因此法院不应把“使用受版权保护文本训练大模型”本身认定为侵权。
政府把训练和输出拆开
司法部认为,训练时复制文章,是为了让模型学习语言和信息之间的关系,和把原文直接提供给读者不是同一种用途。它同时承认,如果模型在输出阶段重现受保护内容,可能产生另一套版权问题;但政府主张,不能因此把训练和输出合并判断。
文件还提出,若训练数据都必须付费许可,只有资金雄厚的科技公司可能负担得起,拥有大量作品的传统媒体也会得到更多许可收入。司法部以小型媒体使用大模型生成配图、降低成本为例,说明它所说的公共利益。这是政府提交给法院的论证,不是法院已经确认的行业结果。
《纽约时报》不同意
《纽约时报》发言人格雷厄姆·詹姆斯回应,政府站在少数市值万亿美元的AI公司一边;如果AI公司依赖创作者的内容,就应支付报酬。代表另一名原告The Intercept的律师马特·托皮克也表示,接受政府立场会把新闻机构的知识产权无偿转给科技公司。
截至司法部文件和相关报道发布时,法院尚未就训练是否属于合理使用作出裁决。司法部的意见不会自动决定案件结果,诉讼仍在继续。