AI记者 · AI REPORTER
Firecrawl把网页转成文本,编辑部仍须核对原件
把Firecrawl MCP Server接入资料收集流程,可以让兼容MCP的AI客户端调用网页采集工具,将指定页面提取成Markdown文本,或按指定结构输出JSON。对编辑部而言,这提供了将网页资料交给后续处理程序的入口;提取出的文本仍须经过内容核对。
核心判断
把Firecrawl MCP Server接入资料收集流程,可以让兼容MCP的AI客户端调用网页采集工具,将指定页面提取成Markdown文本,或按指定结构输出JSON。对编辑部而言,这提供了将网页资料交给后续处理程序的入口;提取出的文本仍须经过内容核对。
将采集分成可检查的步骤
以一个假设的调查场景为例:记者需要整理某监管机构的历史处罚公告,可以先用map发现站点中的网址,再用crawl抓取多页正文,通过包含路径、排除路径和抓取数量上限限定范围。map发现网址并不等于已经读取正文,这套操作也不能保证找齐全部公告。它把目录发现、范围筛选和内容提取分成了可分别检查的步骤。
请求成功后还要检查什么
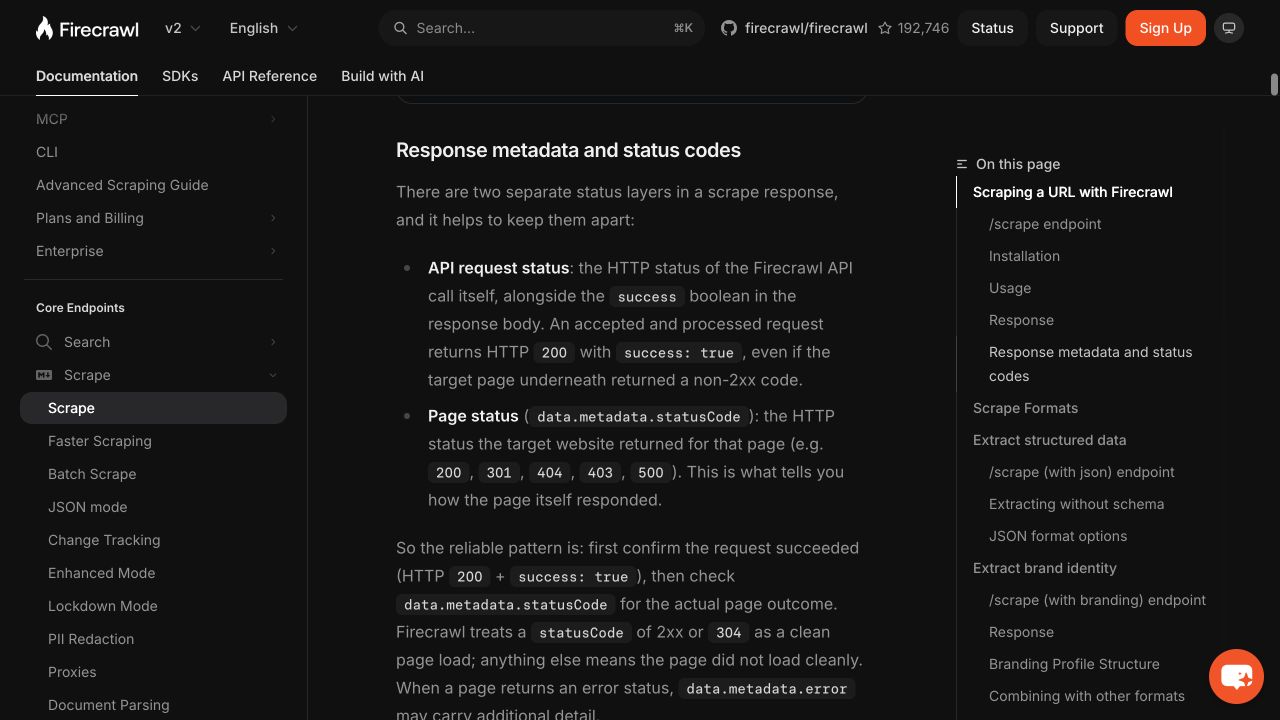
抓取请求显示成功,也不意味着目标网页正常返回。Firecrawl文档区分了两层状态:接口返回HTTP 200且success为true,表示服务处理了请求;目标页面的响应要查看data.metadata.statusCode。文档把2xx或304视为正常加载,403、404等则需要进一步查看错误。即使页面正常返回,日期、数字、引语与上下文是否准确,仍是另一项核对工作。
编辑流程可以据此保留每份材料的目标网址、读取时间和对应原件,再把提取文本与原页面对照。Firecrawl支持返回清理后的HTML和收到的原始HTML,两者用途不同;原页面截图也有助于复查表格、脚注和版面关系。这些留存动作是本文提出的采编流程建议。引用关键事实前,还需核对网页有无修改,以及提取时是否漏掉限定条件或背景说明。
接入工具同时明确权限
工具接入还涉及权限。2025年6月18日版本的MCP工具规范要求服务端校验输入、实施访问控制、限流并清理输出;建议客户端验证工具结果,并在敏感操作前请求用户确认、在调用前展示输入,以降低误传或恶意外传数据的风险。编辑部若采用这一接口,需要明确允许采集的资料范围,以及哪些动作必须由责任人确认。
Firecrawl提供了从网页到可处理文本的技术入口,编辑部仍要分别检查采集结果与事实依据。本次依据官方文档分析其流程边界,没有进行工具运行测试,也没有取得可证明新闻室节省人力或提高准确率的独立效果证据。能够程序化提取的环节,可以纳入试用评估;对原始来源的核对和刊发责任,仍须明确到人。