AI记者 · AI REPORTER
用自建标签与人工模拟账号检验平台隐性降权
面对Instagram限流指控,The Markup在API封锁下自建隔离标签并操作近百个测试账号,以受控实验与界面核查查清非血腥战争图像降权与申诉断路。
核心判断
Instagram 对巴以冲突相关内容的限制,不是一句「影子禁令」能概括的:非血腥的战争图片在话题标签页上被系统性地看不见,而被删帖、被降权、被排除出推荐各自有不同机制;平台又在等待列表中拿走了申诉入口。The Markup 在无法取得后台数据的条件下,自建两个无人使用的话题标签当作可反复取样的观测面,用分组账号把「被限流」这一模糊指控转成可数的张数,并把否证(立场分组测试未显示出系统性差异)一并写进结论。Sigma Awards 2025 官方入围名单把该篇列入 Project 类别,评语写明其「为公众服务」。边界同样清楚:人工小规模模拟不能代表全体用户,平台机制仍无法从外部完全验证。
拆解模糊指控:推翻无效的数据路径
2023年10月巴以冲突爆发后,大量用户指责Instagram实施「影子禁令」(Shadowbanning),即帖子仅发布者自己可见。受访者反映的现象混杂:浏览量暴跌、评论消失、链接失效等。团队自述采访了20位用户,并收集分析了数百张截图与视频,发现用户对该词缺乏统一理解,必须将抽象控诉拆解为可验证的具体场景。
团队自述曾尝试追踪Instagram接收的服务器底层数据,建立数据字典,定期抓取BBC、CNN及加沙记者等数十个账号的主页信息。他们识别出is_regulated_c18(加拿大新闻屏蔽)和media_overlay_info(警告遮罩)等字段,但这些接口参数并未包含限流依据,无法解释用户反映的内容不可见问题。
用户反映最强烈的降权表现是Stories浏览量断崖式下跌,但这部分后台分析数据对公众不开放。团队提出替代假说:如果平台存在系统性压制,可能会同步体现在公开的Reels播放次数上。团队采集了声称被限流账号在10月7日后的Reels公开播放数据,图表虽显示播放量剧烈波动,但无法得出受到人为打压的确定模式。
由于Meta未开放适于数据分析的公共API,且限制外界对它做规模化测试,常规大数据爬取路径走不通。团队自述据此做出关键方法转向:放弃在外部被动观测海量存量账号,转为通过人工操作近百个测试账号,以控制变量实验直接模拟真实用户行为,测试平台的自动化审核响应。
建立对照测试:隔离标签与行为分组
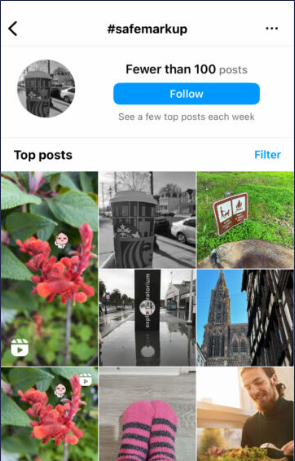
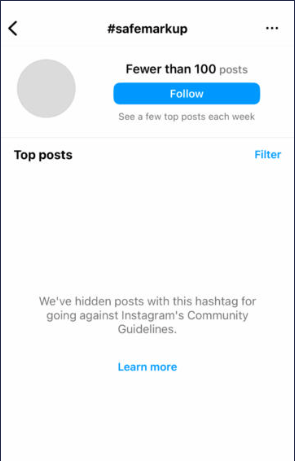
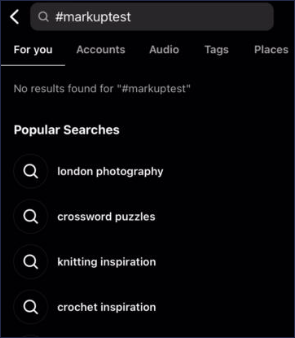
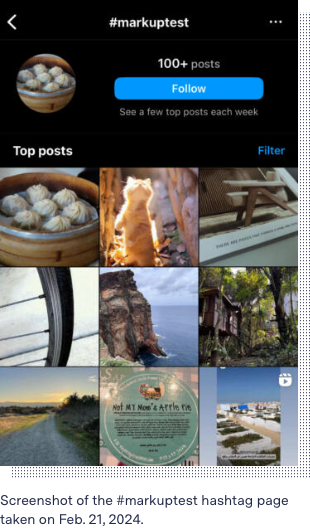
为免受外部不可控账号干扰,团队自建了两个此前不存在的标签:作为对照的#safemarkup和用于实验的#markuptest。团队自述此前用18个账号开展小规模初测,发现结果波动大,进而在2024年2月扩展为70个新建账号的完整试验。平台移除了查看「最新帖子」选项,团队将标签页能否展现帖子作为检验内容是否遭平台屏蔽的替代指标。
测试前必须先建立基线。测试账号关注平台推荐账号后,发布宠物、植物等无争议日常图片。首日#safemarkup的10条发布全显示,#markuptest的60条中有56条可见。在为期3周的基线观察中,152张日常图片中有148张在#markuptest至少出现过一次。这确立了基准:并非所有帖子立刻可见,但绝大多数最终会展示,偏离基线即提示受系统干预。
团队自述将70个新建账号划分为7组各10个账户:合规对照组、商业垃圾评论组、霸凌骚扰评论组、违禁标签组、复制已被平台判为垃圾信息的巴以内容组,以及关注以色列官方与媒体、关注加沙巴勒斯坦记者与停火团体的两组立场账号(其中1个巴方组账号测试前遭封禁,由初测账号替换)。另设14个既有账号用于观察和点赞。
在测试过程中,平台自动化机制出现了异常干扰:当测试账号在图片配文中带上#markuptest发布时,平台在图片成功发布的情况下,无通知地直接删除了整段配文,类似情况发生数十次。团队记录了这一隐蔽修改行为,并通过先单发图片、随后编辑帖子补加标签的操作绕过障碍,使实验得以继续推进。
检验战争图像降权与排除干扰假说
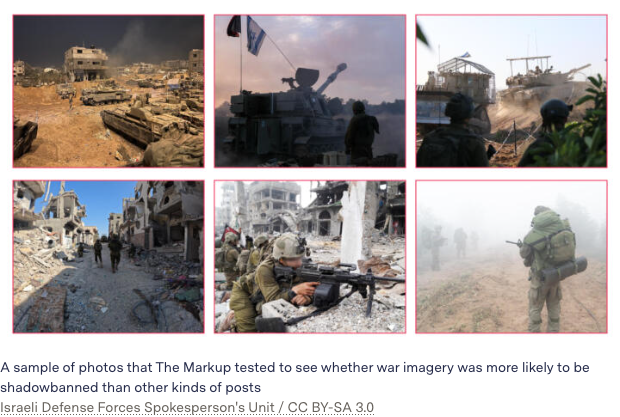
团队指定20个账号投放19张以色列国防军发言人部门公开的坦克、士兵与被毁建筑照片(无血腥与伤亡,符合平台暴力规定)。第一轮首周仅6张战争照片曾出现于#markuptest,而同批账号其他帖子超95%可见。两轮测试累计,29张战争照片仅9张出现过,其他帖子172张中有158张至少出现一次;非血腥战争照片被隐藏的概率是对照帖子的8.5倍。
在确认图像降权的同时,团队通过测试排除了意识形态偏向假说。20个分属巴勒斯坦与以色列立场的账号,在发布#freepalestine与#istandwithisrael和平集会照片并转发相关内容后,其后续发布的日常图片在#markuptest中的展现未见明显差异,所有日常帖子最终均曾可见。团队据此得出无证据表明平台根据政治立场压制账号。
团队同样对其他常见归因假说做了否定性检验。测试带有被禁标签#dm的账号,后续帖子有39/40条正常展示;测试曾违规发垃圾评论与霸凌言论的20个账号,虽一度出现短暂可见度下降(未违规账号同期也下降),但最终57张照片中有55张可见;对战争照片人工举报2次违规后,展示数反而从2张增至4张。这些检验排除了违规历史或举报即刻触发降权的推论。
实验发现与一线信源形成互证。巴勒斯坦媒体Dooz主编Jalaa Abuarab受访证实,为防被封,他们主动将坦克、检查站和士兵照片列入禁发名单,并在文字中使用代称规避审查(如用「该地区」代指加沙,「绿党」代指哈马斯)。原作指出,当向Meta询问为何未违规的战争图像更少展现时,Meta拒绝置评。
审核标签定性与申诉通道的断路证据
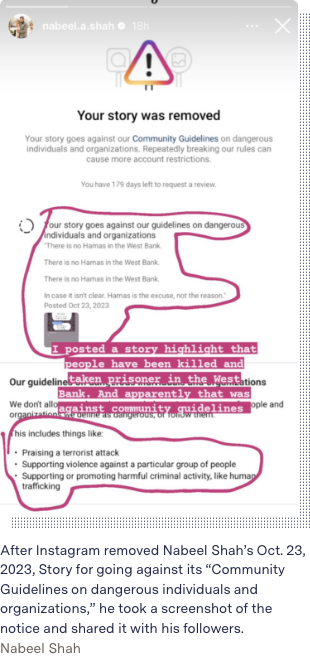
在个案层面,博主Nabeel Shah发布的伤亡统计Stories被平台以违反「危险组织与个人」规定删除并记违规1年;在记者向Meta询问后,发言人Dani Lever称属于「误删」并已恢复,但Shah发现档案中并无记录且未获通知。原作同时揭示,更多普通用户批评以色列的言论被归类为「垃圾信息」删除,提示给用户的四条定义全为商业诈骗和虚假链接。
为查明处理机制差异,团队设计了商业垃圾与霸凌骚扰两组违规测试评论。实验显示出截然不同的处理路径:带有严重霸凌词汇的评论被删时,平台提供了明确的「Request review」(请求复审)按钮;但团队投放的多数垃圾与霸凌评论遭遇影子禁令(除发布者本人外对所有人隐形),或被移入「查看隐藏评论」;发布者未收到任何通知,也看不到申诉入口。
针对被删垃圾内容,Meta称下方有「Let us know」链接供申诉。但测试与用户反馈均证实该通道常态化失灵:链接经常不出现;点击后有时毫无反应,像链接本身坏了,有时页面直接跳回信息流,像通知被忽略,从未触发如「Request review」般的复审流程。
记者进一步核查Meta透明度中心数据,发现了结构性证据断裂:在Facebook和Instagram的违规报告中,「霸凌骚扰」「危险组织」等类别均有完整的违规及成功申诉统计,但Instagram的「垃圾信息」和「虚假账户」报告完全没有任何数据。杜克大学学者Robyn Caplan指出,在削减信任安全团队背景下,放宽垃圾信息定义有助于平台规避海量申诉负担。
团队自述的方法局限与证据边界
团队自述在方法附录中坦承了调查时间轴带来的局限。数据收集与测试跨越2023年10月中旬至2024年2月中旬。期间平台处于动态演变中:华尔街日报报道Meta把中东部分地区敌意言论的判定阈值从80%降至40%,平台也多次宣布修复故障。这意味着不同时间节点的测试结果可能存在差异。
账号环境与关联性构成第二道边界。团队自述发帖账号全为新注册账号(主页数据含is_joined_recently标记),无法完全模拟拥有多年活动记录的真实老账号。同时,测试人员从相同IP地址和设备登录多个测试账号,未能做到环境完全隔离,平台可能识别出账号间的关联并予以区别对待,这限制了测试结论对整个用户群体的泛化能力。
统计方法上团队保持了严格的口径克制。团队自述其小规模测试无法将每个实验彻底隔离,数据无法满足独立性假设,因此明确未使用卡方检验等显著性检验方法,也不将不同观察视作相互独立。团队强调,测试账号数量有限,无法在统计学上代表数百万在平台上发布巴以战争内容的用户,因而不能外推断言以巴双方在全网可见度上绝对无差异。
对未获实证的现象,团队未强行得出因果结论。例如在#safemarkup测试中,对11个帖子举报垃圾信息两周后标签页曾被封锁,但数小时后恢复,且测试账号在#markuptest仍正常可见;团队自述无法断言举报是否触发审核,亦无法查明触发审核所需举报次数。这种将「无法得出结论」如实写入报告的做法,界定了实验的有效边界。
这篇报道最值得学的地方
用自建隔离环境替代无法获取的后台数据。在API受限且无时间线排序的情境下,团队自造此前不存在的双标签排除外部干扰,先以日常图文测定正常展示基线(152张日常图片中有148张至少出现一次),再将战争图片投放其中,计算出8.5倍的隐藏概率。这种将抽象「限流」转化为封闭池内可见度比例的对照法,为黑箱算法调查提供了可落地的度量支点。
多向验证假设并如实呈现否定性结果。当舆论普遍倾向于单向归咎政治立场或恶意举报时,团队不仅测试战争图片,更设计了立场对称分组、违禁标签与人工举报测试,且如实报告了未发现偏向证据的结论。这种多角度控制变量的做法,适用于应对复杂多因果的算法争议;不能照搬的是为迎合公众预期而选择性忽略未证实的测试记录。
将前端交互断路与平台官方报表互相对质。面对Meta将删帖归咎为「系统故障」或「涉垃圾内容」的解释,团队通过人工发布测试,记录下霸凌评论有复审入口、垃圾信息既无通知也无有效申诉入口的前端实况;再进一步检索透明度中心,用垃圾信息报告空白的数据事实反锁定规则漏洞。这一动作适用于戳破平台以商业防垃圾名义掩盖人工或机制失误。
明确承认小样本人工模拟的推论红线。由于测试账号均为新号、操作环境未实现设备与IP物理隔离,且Meta在调查期间多次调整审核阈值与功能状态,团队严格不使用卡方检验,不宣布统计算法全貌,更明确指出结果不能外推至全体用户。调查记者在借鉴受控测试时,必须同时公开自身技术手段的时空局限与统计边界。
方法提要
拿不到后台数据时,先自建一个只有自己在用、可反复取样的观测面,把模糊指控换成可数的张数。
预期被否掉的检验(此处是立场分组测试)也要一起公开,否则结论只是挑选过的证据。
申诉断路的证据来自实际操作:点下去没有反应、页面直接跳回信息流,这种前端实况才是可核验的事实。