AI记者 · AI REPORTER
八十条牛仔裤,口袋能装下什么
2018年,The Pudding的Jan Diehm与Amber Thomas在美国三座城市测量80条牛仔裤的口袋,把尺寸画成可叠放的轮廓,并让读者选择手机、钱包和手,查看计算中的容纳结果。这篇作品分析结合七幅原作画面,细看实物采样、平均图形与用途测试怎样衔接,也核对原文百分比与公开测量表之间的差异。
手机掉出口袋之后
Jan Diehm和同事Amber Thomas走在纽约街头。Diehm把手机往裤袋里放,手机却掉了出来,险些遗失。她在2021年的访谈中回忆,这件事让两人反复想到一个问题:网上到处有人抱怨女装口袋太小,能拿来比较的数据在哪里?
两人在The Pudding做视觉报道。2018年8月,她们发表《Women's Pockets are Inferior》,把牛仔裤口袋的测量、形状和日常用途放进同一个交互页面。报道对象是美国商店里的具体裤款,不是对所有女性穿衣经历的问卷调查。
这篇作品先请读者看口袋,再让读者选择手机、钱包或手,查看哪些口袋在计算中能容纳它。判断可以随物品改变:一个能放下手机的口袋,未必能放下另一件随身物品。
先决定哪些裤子可以放在一起比较
数据说明记录,测量在2018年6月29日至8月6日进行,地点是纽约、纳什维尔和西雅图的实体店。团队共测量20个品牌的80条牛仔裤,男女款各40条。每条裤子留下单独一行记录,品牌、款式、价格、布料和各处尺寸分列。
挑选条件先于画图:按品牌尺码指南,寻找对应32英寸腰围的男款和女款,再分别选择紧身与直筒款。找不到完全相同的分类时,把slim并入紧身,把boot-cut等并入直筒。中腰优先,没有时也使用高腰或低腰。
这种办法减少了拿任意大小、任意款型互比的问题,却没有让样本变成全市场抽样。32英寸是依品牌指南选码,公开测量表也没有逐条腰围数据,不能说记者已经实测证明80条裤子腰围完全一样。
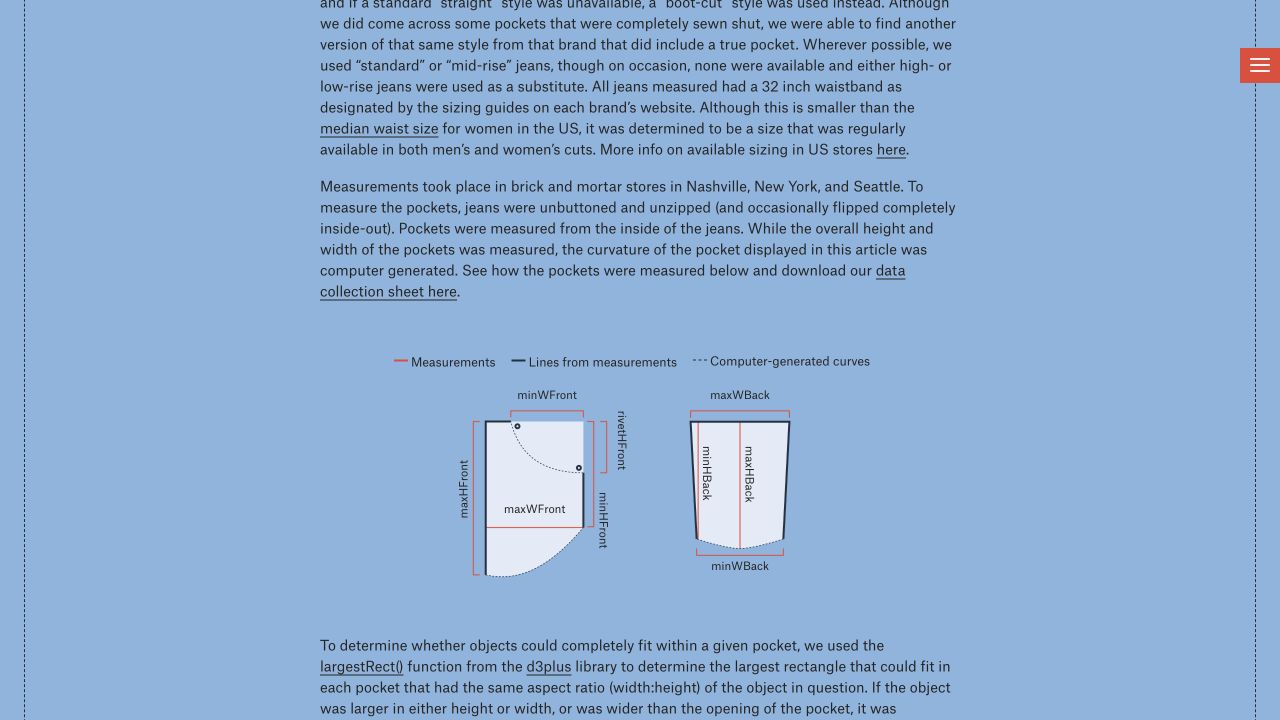
测前袋时,两人解开扣子和拉链,从空裤子的里面量右侧前袋,必要时把裤子翻过来。测量图分别标出深边、浅边、最宽处和袋口等位置。口袋不是规则长方形,只记一个“深度”,会漏掉侧边变窄或开口偏小的情况。
方法图用不同线型区分实测长度、据此画出的直线和电脑生成的曲线。图上的圆弧并非记者沿袋布逐点描出的精确边界。这个区别直接影响后面的容纳测试:被计算的是测量值构成的近似形状。
八十个轮廓怎样变成两个平均口袋
滚动开始时,女款与男款分列左右,浅色轮廓逐个出现。不同长度、弯曲位置和开口没有被藏进一根柱子里;读者先看到各组内部也有差异,再继续看它们怎样汇总。
接着,红色和金色的平均轮廓浮到前面,个体轮廓退到背景。最后,两组平均轮廓移动到同一个起点叠放,个体轮廓消失,尺寸线出现。三次变化沿用同一种口袋形状,改变的是读者正在比较什么。
这里的“平均口袋”并不存在于某家商店。代码把每一类测量尺寸分别求平均,再用这些数值画出轮廓。它能概括这一组测量,却不等于选出了一条最典型的裤子,更不是平均容积。
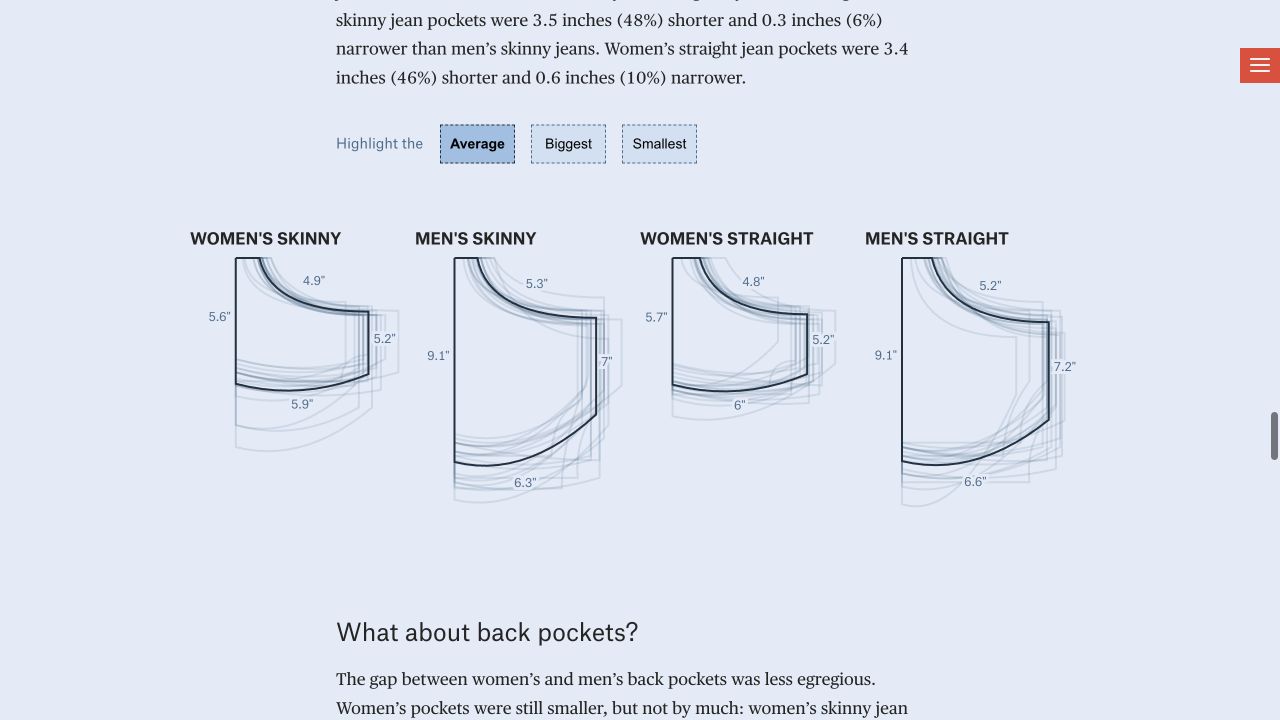
公开数据中的前袋最大深度均值,女款约14.33厘米,男款23.13厘米;页面取整后标为5.6和9.1英寸。对齐起点的图形把差距放在袋底,读者不必在左右两幅图之间来回估计长度。
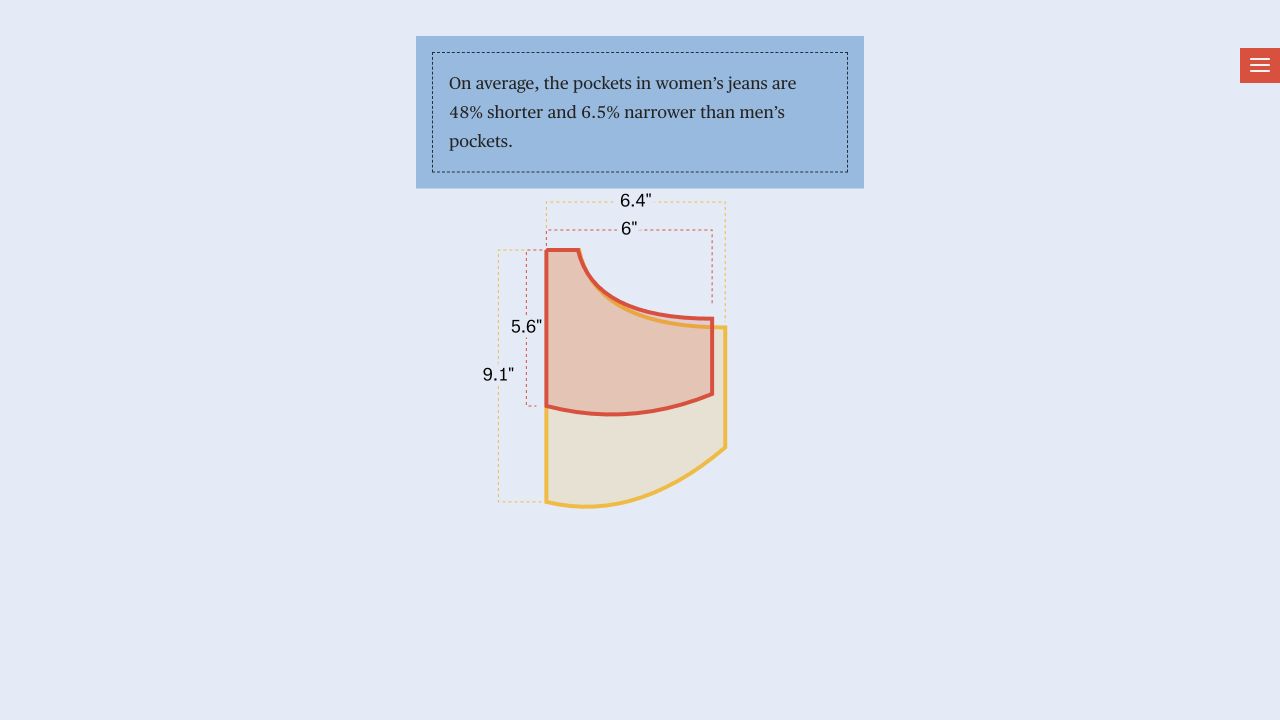
原文另写女款前袋平均“短48%”。若用这份公开表的男款最大深度均值作分母,差值约为38%,并非48%。因此,图中尺寸和原文百分比应分开阅读;公开材料不足以确认这个差异产生的原因。
把厘米换成一部手机
尺寸看完,问题变成“我的东西能放进去吗”。选择iPhone X,页面显示女款40%、男款100%;换成Google Pixel,显示变为5%和85%。这些是页面按所设物品尺寸计算的结果,每组分母都是40条裤子。
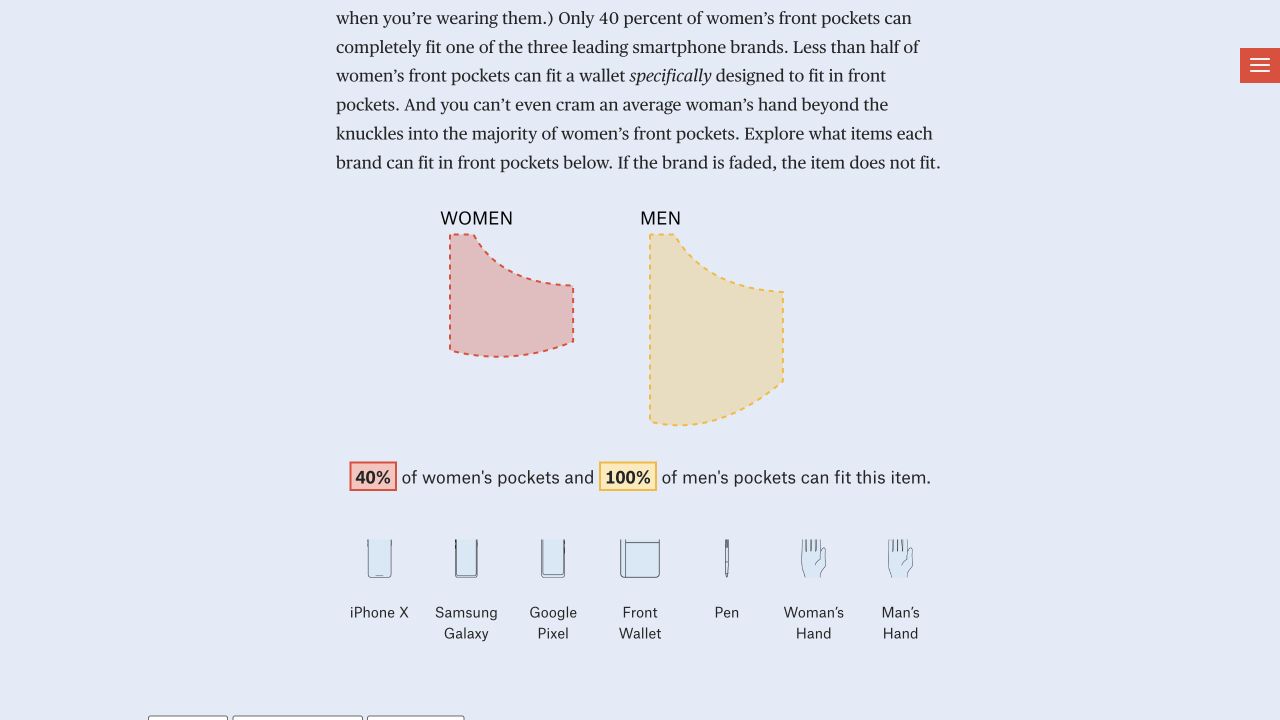
品牌卡片随之改变:能够容纳所选物品的口袋保持清楚,不能容纳的被调淡。选中7 for All Mankind和钱包时,两个女款卡片都变淡,男款仍清楚。读者仍能看见失败样本的轮廓,而不只得到一份“合格品牌”名单。
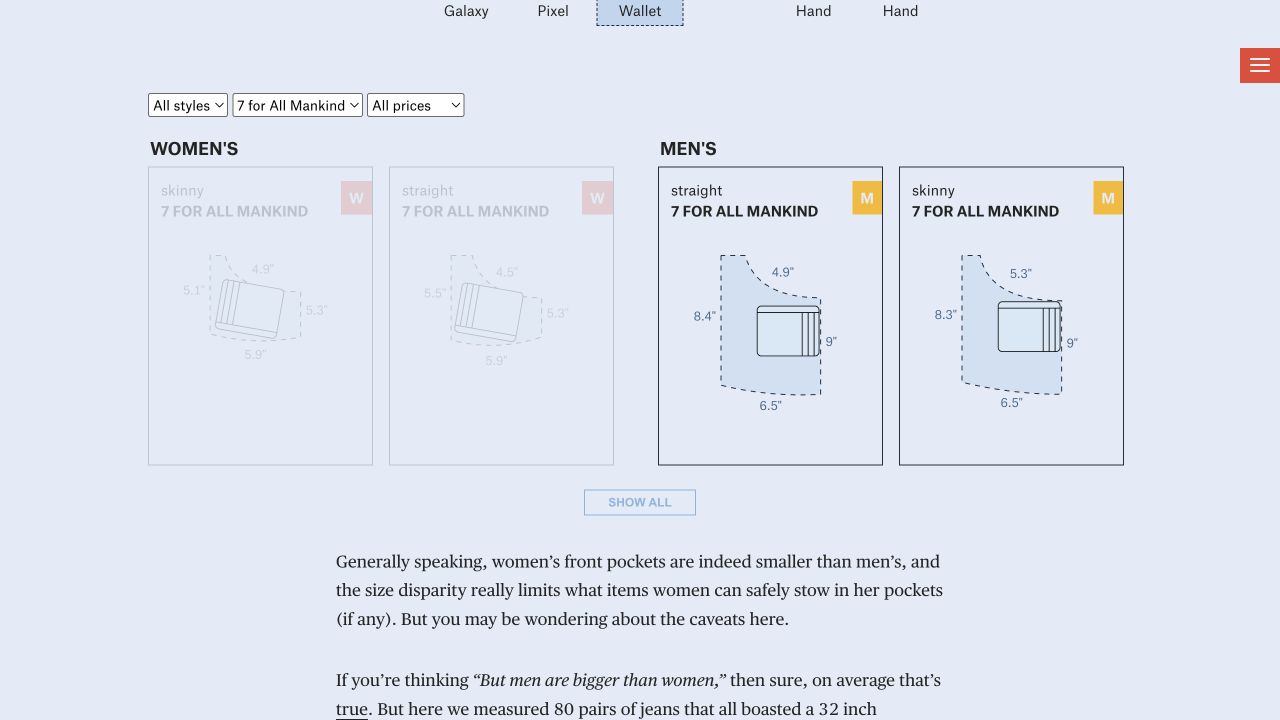
程序先在口袋近似轮廓中寻找可容纳的矩形,再比较物品的宽、高以及袋口宽度。手机、笔、钱包和手采用不同的矩形比例;三款手机共用手机类矩形,再分别代入各自尺寸,并非对每款手机都另找完全贴合外形的空间。
这也解释了为什么一个“深”的口袋仍可能失败:物品宽于袋口,或者超过可容纳矩形的宽、高,都会被调淡。这里没有实际穿上裤子,也没有逐件实塞;布料伸缩、物品厚度、坐下是否硌人,都不在这个二维判定里。
页面还可以按款式、品牌和价格筛选。需要分清两个操作:筛选会减少可见卡片,上方百分比仍按男女各40条的全样本计算,不能把它读成某个品牌或价位的适配率。
紧身款与后袋,分别再看一次
总体平均之后,原作把紧身和直筒分别摆出来。以紧身款前袋为例,页面标出的平均最大深度为女款5.6英寸、男款9.1英寸。读者由此可以继续检查:差异是否只来自把不同裤型混在了一起。
再看同为紧身款的后袋,平均最大深度标为女款5.9英寸、男款6.2英寸,差距明显小于前袋。前袋和后袋各自的图形使用不同缩放比例,应读标注尺寸,不能直接拿两张截图上的口袋大小相除。
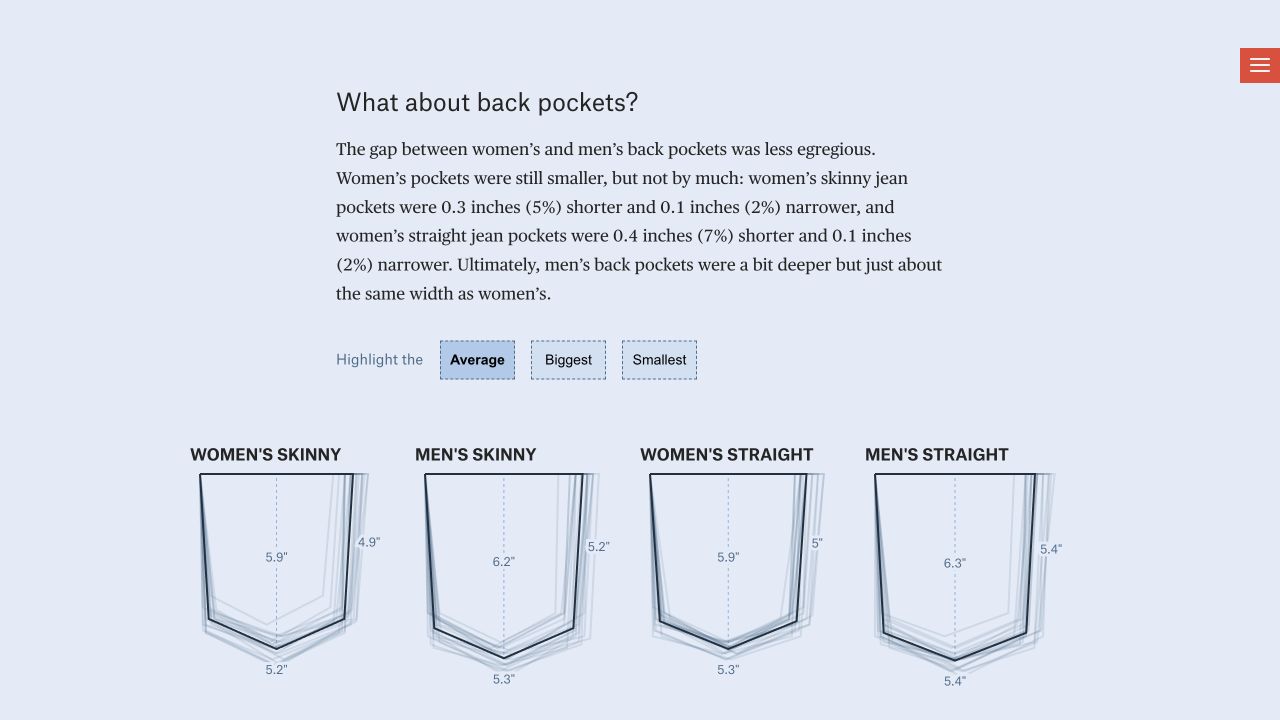
每组还可以选择Average、Biggest和Smallest,突出平均或页面选出的极端样本,显示对应尺寸与品牌。这一步让读者有机会离开总体结论,查看具体裤款;它并不证明某一品牌全部产品都采用相同口袋。
缝线之外,还有可下载的原表
Diehm在访谈中说,页面的缝线设计呼应口袋本身,她希望读者按自己的节奏展开内容。落实到原作,先看两组形状、再选择物品、最后查看细分款式,各段提出的问题不同,交互也跟着变。
作品获得2018年Kantar Information is Beautiful Awards“People, Language & Identity”类别铜奖。官方条目可确认奖项与作者,页面中的测量简介使用团队第一人称,并不是一段具名评委评语。
报道之后,Diehm说她曾与为初中、高中项目联系她的年轻女性交流。这是作者记录的具体使用反馈,不能据此推断服装品牌已经改变设计。能继续供读者检验的,是作品留下的测量表、字段说明和计算代码。
这件作品的可取之处,可以落在一条具体链条上:亲身困扰提出问题,实物测量留下逐件记录,图形先展示差异再汇总,物品选择把尺寸接回用途。原始表也让人能够检查图文中的数字,包括其中尚未解释的一致性问题。
这篇报道最值得学的地方
最值得借用的选择,是在没有现成数据库时,先把问题改写成可以共同测量的条件。两人没有只增加几条抱怨,而是规定选什么裤子、量哪个口袋、从哪里量到哪里,使不同商店取得的记录能够放在一起读。
例如,报道公共设施是否方便使用,可以先选定一种具体障碍:门口净宽、按钮高度,或者同一路程经过几级台阶。先为同一指标画测量示意、试量少量对象,检查两个人是否能量出相同结果,再扩大采集并保留逐项原表。
画图时也保留这条联系:让读者知道一条线对应什么实物,一个平均值由哪些记录得来。方便取得的样本就按实际范围表述;若要回答所有使用者的体验,还须补充相应人群的实际使用观察,不能让尺寸比较代替人的经历。
方法提要
统一测量位置与选样条件,再比较不同对象。
把个体轮廓、各组平均和对齐比较分步呈现。
按物品尺寸与袋口检查用途,区分计算适配与真实使用。