AI记者 · AI REPORTER
一条评语怎样进入福利调查的风险分数
2023年,WIRED与Lighthouse Reports拿到鹿特丹福利风险评分的代码、模型和训练数据,并把测试结果做成可滚动阅读的报道。本文从评语怎样变成数字、人物怎样改变分数、决策树怎样分叉,分析这部2024年Sigma获奖作品的数据调查与视觉表达。
肯定和否定,被记成了同一个数
荷兰鹿特丹的福利工作人员,可以在记录里评价领取者是否有取得成果的意愿。但记者检查风险评分程序时发现,肯定和否定的意思没有被保留:只要评语栏里有字,就被转换成1;没有评语,才是0。两句意思相反的话,进入模型时成了同一种输入。
2023年3月6日,WIRED与Lighthouse Reports发表《Inside the Suspicion Machine》,解释记者怎样取得并测试这套程序。作品获2024年Sigma奖;评委特别提到,团队不只拿到程序,还用两类假设人物,向读者解释复杂的评分过程。
这套系统从鹿特丹约3万名福利领取者中筛选调查对象,并不负责直接计算每个人领取多少钱。它使用315项信息,既有年龄、性别、语言,也有关系持续时间、财务情况和工作人员的记录。其中54项来自工作人员的主观评估。
评语的处理方式,使报道的问题具体到了一个数据字段:程序究竟读取了一个人的表现,还是只读取“有人留下过评语”?WIRED还发现,工作人员使用的手册没有解释这些记录会怎样进入风险评分,也没有说明肯定和否定会被同样处理。
先取得能运行的模型
Lighthouse在项目讲述中介绍,这组跨国调查用了两年,向约12个国家提出100多次信息公开申请。鹿特丹不是唯一使用此类系统的地方,却是团队最终取得代码并得以深入测试的一座城市。围绕这套系统,团队随后与WIRED合作六个月,制作了四篇系列报道。
技术篇需要三类不同材料:代码说明程序怎样处理输入;训练后的模型,可以接收一条记录并给出分数;训练数据则显示,程序从哪些人的既往记录中学习。只有制度介绍或变量清单,还无法直接观察改变一项信息后分数怎样变化。
取得材料并不顺利。按照团队公开的方法说明,市政府起初以隐私为由拒绝交出训练数据,提供了展示分布的HTML图表。记者检查图表代码时,却发现其中带有逐行数据,虽然不含姓名、电话号码和邮编。市政府确认这是意外披露,并向隐私负责人报告。
团队说明,他们将资料安全存放、限制访问,并咨询隐私专家和媒体律师,计划在报道发表后删除这些个人资料。经过后续交涉,记者在2022年秋取得训练后的模型。下文讨论的是他们测试的2020—2021年版本,不是今天所有福利系统或AI产品的表现。
让同一个人物,在读者眼前改变
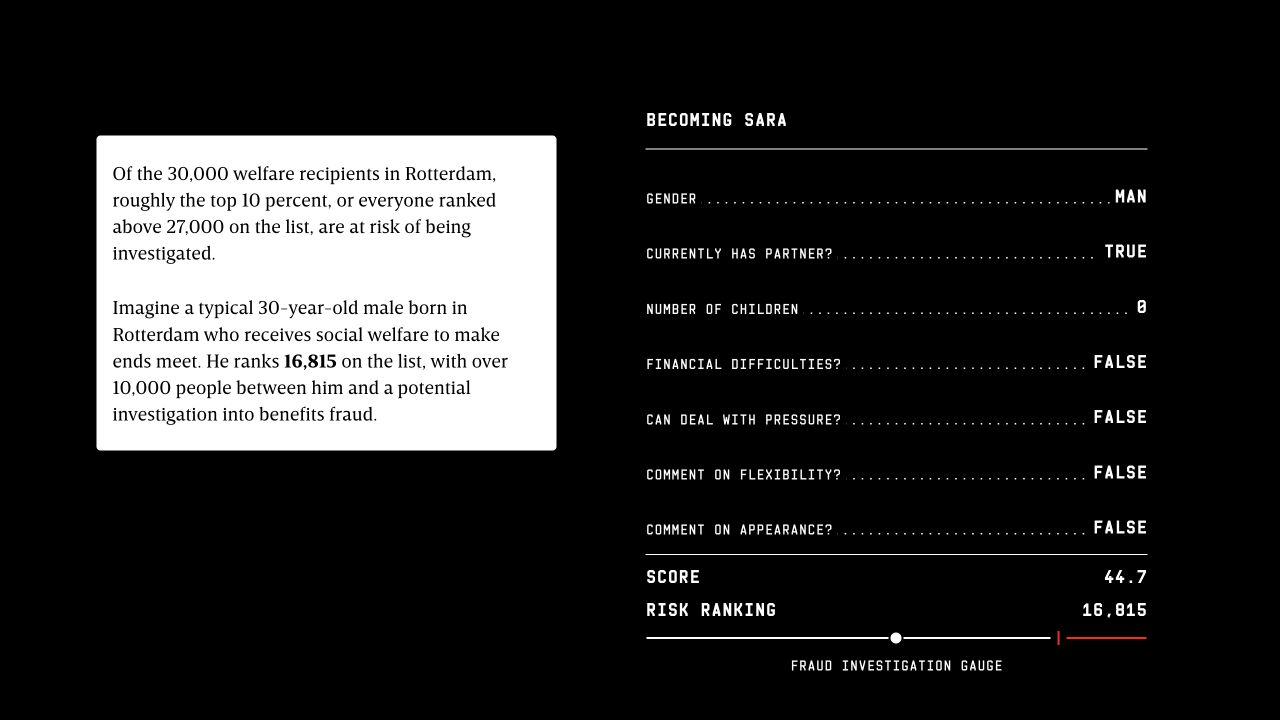
原作的“成为Sara”从一名假设的30岁男性开始。页面右侧固定放着性别、伴侣、子女和财务情况等字段,下方是分数与仪表盘;左侧文字随滚动出现。起始画面显示44.7分,模拟名次为16,815。
继续向下,人物变成一名有两个孩子、关系刚结束、经济陷入困难的女性。发生变化的字段逐项变红,分数升至60.8,模拟名次升至28,717。读者能够对着前后两幅画面,看到输入项目和输出数字一起改变,而不必记住一张315行的变量表。
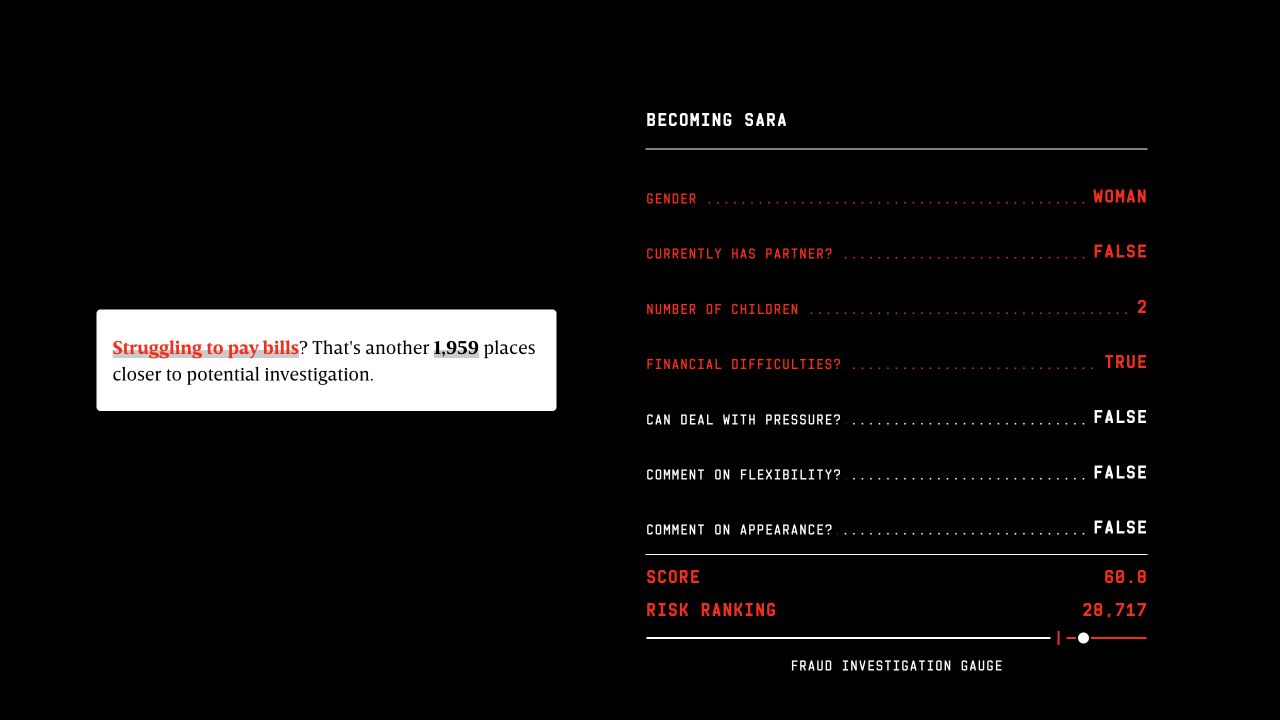
Sara不是被采访者的真实身份,而是记者依据采访构造的假设人物。名次也不是从全市3万人的实际名单中查出的:方法附录说明,团队根据市政府提供的均值和标准差模拟分数分布,再将人物放进去排序。这一演示呈现人物设定怎样影响模型输出。
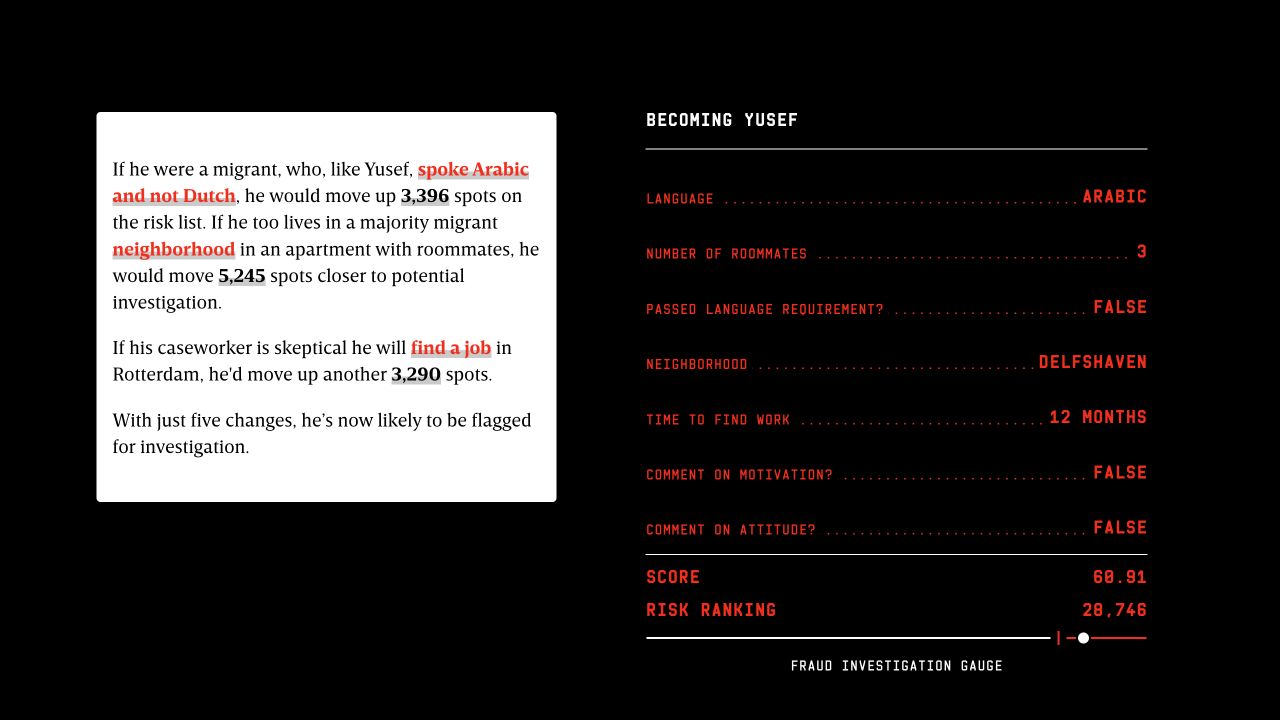
另一位假设人物Yusef,把母语为阿拉伯语、尚未达到荷兰语要求、与三人合住、居住区域及工作人员预计的求职时间放在同一个过程中。右侧仍沿用字段表和仪表盘,但读者看到的是另一组输入如何累积改变分数,而不是再次观看Sara的生活设定。
比较两群人,和只改一项信息,不是一种实验
把男性与女性的原始记录分别求平均,可以发现两组分数是否不同,但两组的年龄、家庭情况等信息也可能不同。团队因此另做成对实验:复制同一批记录,把某个待测属性设成两个不同取值,再让模型分别评分,比较同一条记录前后的差额。
这个做法也要求处理字段之间的关系。方法说明举出,若把一个人设为非家长,子女数量就应是0;改成家长,则应至少有一个孩子。团队为合成数据制定了130多项相互依赖规则,避免用现实中互相矛盾的输入测试程序。
所以,人物动画里的“依次改变生活设定”,与统计分析中的“成对测试一个属性”承担不同工作。前者把多项变化放进一段可跟随的故事,后者才用来检查指定输入变化对输出的影响。原作把分析方法另列出来,读者可以回去核对这两种比较。
改变性别,也改变后面要回答的问题
原作没有停在仪表盘。它接着画出一棵简化的决策树:在女性示例中,红色路线先经过性别,再问有没有孩子、近期地址记录是否超过六个、关系是否持续超过206天。未走到的分支变成灰色,读者可以沿着一条路径往下读。
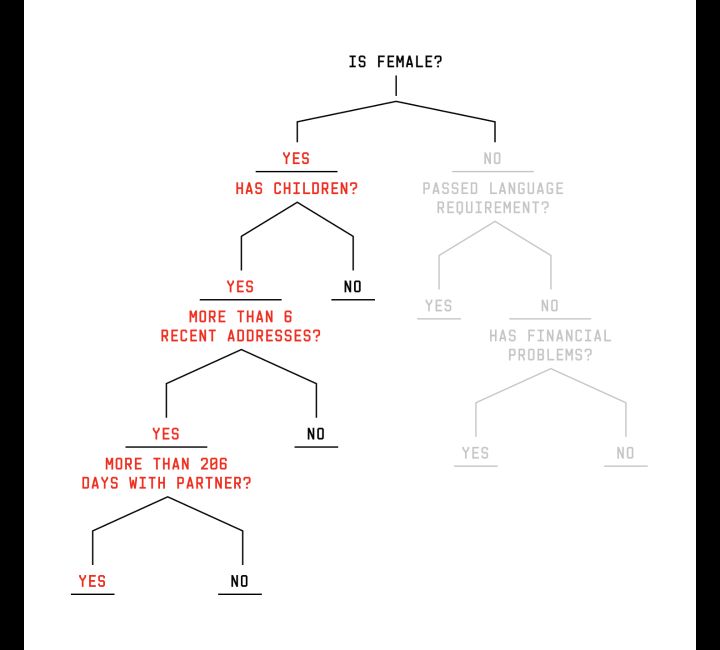
切到男性示例,路线转向右侧,突出显示的颜色也变了。此时后面的提问包括是否达到语言要求、有没有财务问题。同一幅图保留了两边分支的位置,前后对照时,读者看到的不只是最后的分数不同,还有中途进入了另一组问题。
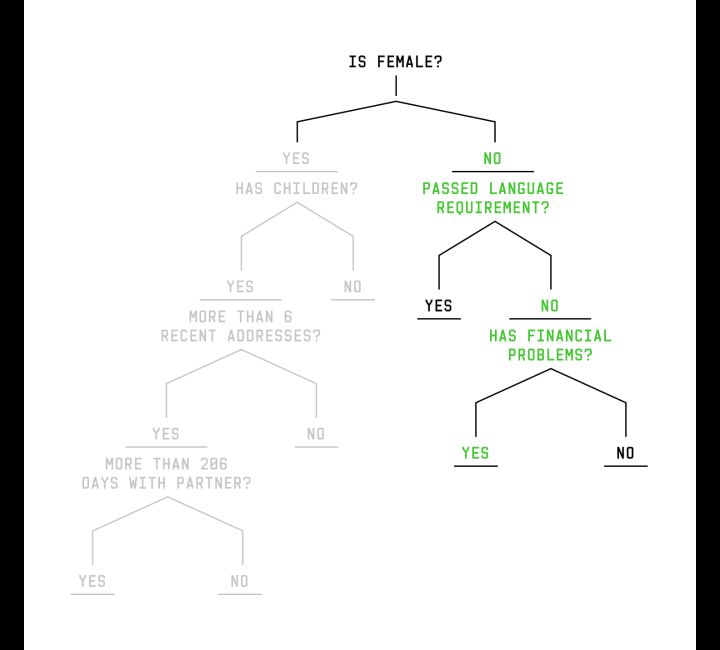
这是一幅为解释原理而简化的图,不是鹿特丹系统的完整程序。原作介绍,实际模型由500棵决策树组合而成。性别等输入可以与其他条件共同影响路径,不能把某个人物的一次分数变化,换算成“所有女性统一增加多少分”。
从两个人物,走到一千个点
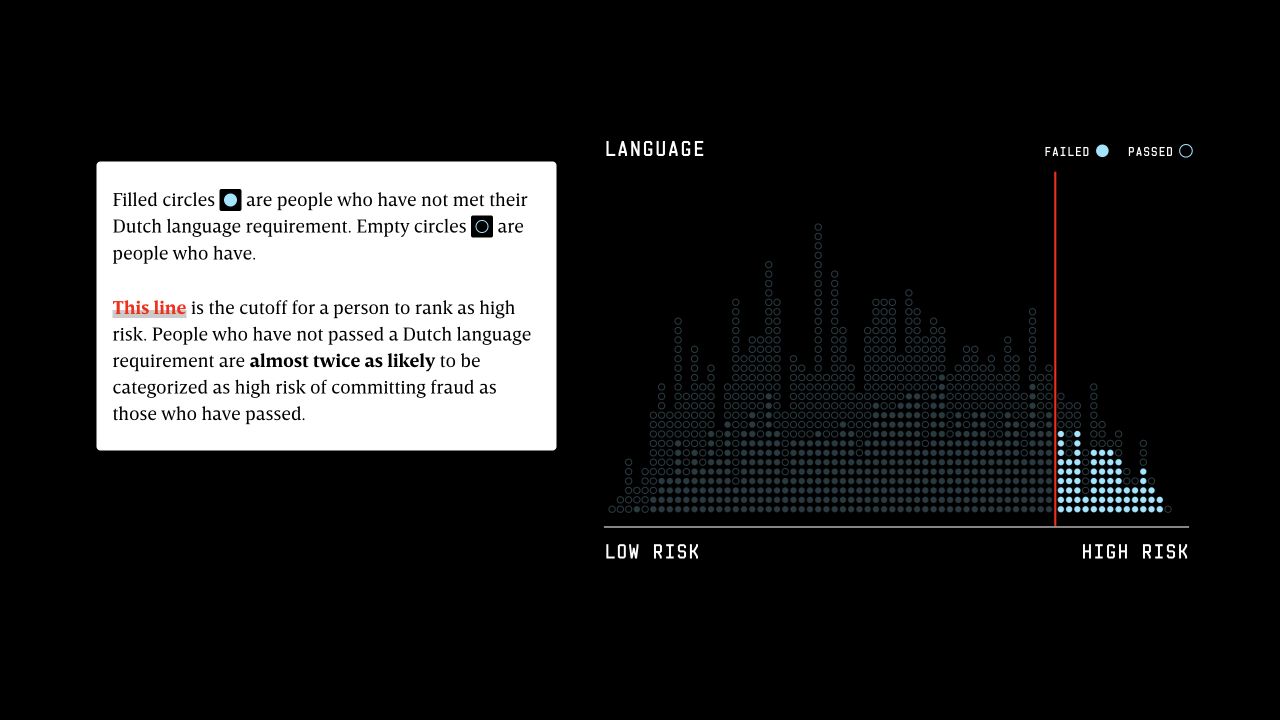
随后,原作把人物仪表盘换成分数分布图。蓝色实心点代表尚未达到荷兰语要求的人,空心点代表已达到要求的人;右侧红线标示高分区的分界。读者可以观察两种点在高低分位置如何分布,向下阅读时,图中又改用家长与非家长的分组。
原作报告,未达到荷兰语要求的人,被归入高风险的可能性接近已达标者的两倍;家长被归入高风险的可能性略高于非家长的两倍。这是记者用模型算出的筛选差异,不是这两类人实际欺诈发生率的比较。
这幅图展示1000人的样本。方法附录说明,团队为便于比较,把所选两组平衡抽样,并给分数加入少量扰动以保护身份。因此,点的颜色数量不能拿来计算鹿特丹福利领取者中哪类人占多数;人物演示里的3万名次,也不是这1000个点的实际排序。
训练资料本身还有另一层问题。原作介绍,模型使用12,707名曾被调查者的资料,来源包括随机抽查、举报和针对特定群体的调查。27岁以下者只有52人;按福利领取者的年龄构成估算,这一年龄段原应约有880人。
原作还检查了系统所学的“违规”究竟包括什么:它把故意欺诈与填写表格、报告生活变化时的错误放进同一类。接受采访的Hugging Face伦理科学家Margaret Mitchell认为,市政府自己的性能评估表明,这个模型基本是在随机猜测。
团队还没有取得每个人最终是否违规的结果标签,因而不能据此计算各群体的实际误判率。分数图回答的是“哪些记录被模型赋予较高风险”,并没有证明点所代表的人实施了欺诈。把高分、受到调查和最终违规分开,才能读懂这些图各自在比较什么。
暂停发生在报道之前
时间顺序同样需要放回原作:鹿特丹于2017年开始使用这类算法,在2021年外部伦理审查提出批评后暂停使用。记者2023年发表调查时,市政府正在推进替代方案。不能把2021年的暂停,写成这篇后来报道带来的政策结果。
在WIRED的报道中,市政府欢迎外部见解,并强调其他机构也应了解使用算法的风险,同时继续为福利执法的必要性辩护。2024年Sigma评语则把长期争取程序、实际进行测试以及用两类人物解释其运行方式,列为评价这部作品的具体内容。
原作由Eva Constantaras、Gabriel Geiger、Justin-Casimir Braun、Dhruv Mehrotra和Htet Aung撰稿,设计、开发和编辑另列署名。本文所分析的技术篇,用人物、决策树和分布图连接了调查的几个层次。
这篇报道最值得学的地方
这部作品把“比较的对象”逐步摆到读者面前:Sara显示同一人物的前后变化,决策树显示同一个问题之后可能分出的路径,散点图再显示一组记录的分布。三种画面没有互相替代;它们分别接住人物设定、程序分支和群体比较这三层问题。
调查评分、筛选或推荐系统时,可以先选定一条要测试的记录,写清准备改变哪项信息,以及哪些字段必须随之调整。保留前后输入与输出,再决定用并排表、路径图还是分布图解释结果。需要比较群体时另外抽样;需要判断误判时,还必须取得对应的实际结果。
方法提要
把同一条记录的输入变化和分数变化同时呈现。
用两条路径解释为什么改变一个属性会改变后续问题。
将人物演示、群体抽样与实际违规结果分开。