AI记者 · AI REPORTER
公交不准点,学生怎么准时
在一座允许全市选校、却不给多数中学生和高中生保证黄色校车的城市,记者用4,210组路线和数千万条车辆记录,检验“迟到”怎样被交通条件放大。
核心判断
《Transit nightmare》把学生迟到拆成两类可检验的问题:最顺利的公共交通路线本身要走多久,以及车辆在上下学时段实际有多常偏离计划。
为什么学生会被公交困住
巴尔的摩实行全市选校。中学生和高中生不一定就近入学,有人每天要横穿城市;与此同时,它也是马里兰州唯一在小学之后不为大多数学生保证黄色校车的学区。学区给符合条件的学生发公共交通卡,准时到校于是取决于与所有乘客共用的公交、地铁和轻轨。
《Transit nightmare》直截了当地追问:当学校选择权跨越全城,交通系统能不能把学生按时送到教室?
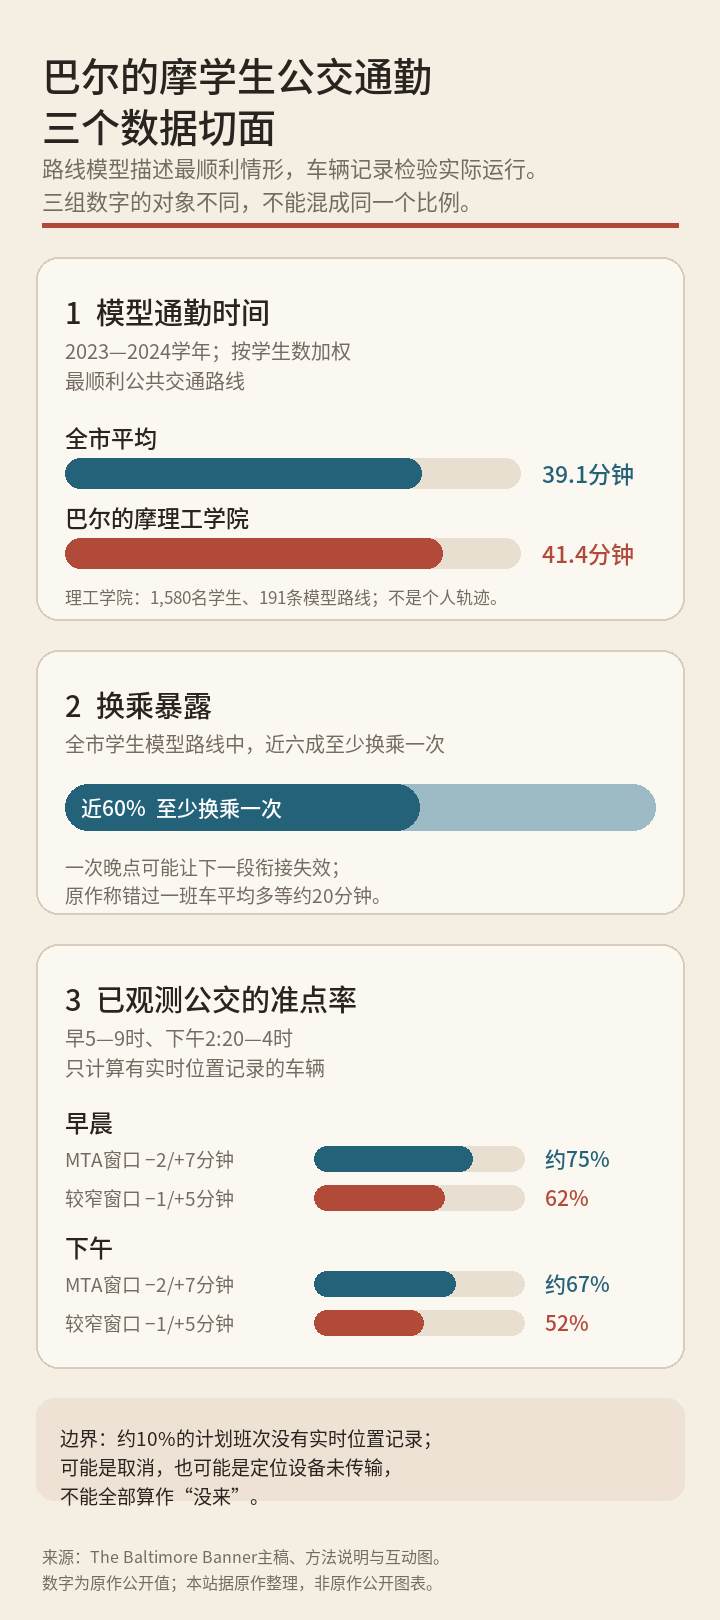
The Baltimore Banner团队把学生采访、学区记录、4,210个“普查区—学校”组合的路线模型和数月公交定位记录放在一起。即使按最顺利路线计算,典型学生单程仍约40分钟,近六成需要换乘;在有实时位置记录的车辆中,早晨约四分之一不符合MTA的准点窗口。
IRE于2026年公布,该作获得2025年Philip Meyer Journalism Award一等奖。这个奖表彰新闻报道对社会科学研究方法的运用;评委特别肯定作品以严谨数据分析呈现学生每天承受的现实后果。作品不是把迟到归咎于学生,而是在检验一种制度组合:全市选校、校车缺位和公共交通不可靠怎样叠加。
作品的结论边界也应先说清。它没有掌握每名学生每天实际走的路线,更没有证明公交问题单独造成某个学生成绩下降或缺勤;它证明的是,公开数据所显示的通勤条件与已观测公交的可靠性,都让准时到校变得困难。
从一名学生开始
布鲁克·伯恩就读于西部高中。原作写到,在车辆按计划运行时,她早晨需约50分钟到校;一次下午回家,5.5英里的路程因两辆车未停站而用了90分钟。后来祖父送她上学,她的一节课成绩提高。
这段人物叙事没有把成绩变化归结为唯一原因。报道同时交代了她的伤病、亲人离世和家庭困境。这样写,既让读者看见通勤如何挤压一节课,也避免把复杂的学习结果压缩成一条简单因果链。
作品随后把个人遭遇放进学校现场。教师蒂姆·法斯说,自己曾在第一节课等到半节课后才讲关键内容;数字港高中的校长则提前45分钟开门,让早到的学生有地方避雨和等候。
原作取得的学区数据表明,高中第一节课的不及格率比当天其余时段平均高6.6个百分点。它把这一并列关系与学生访谈、考勤安排放在一起讨论,而不是声称数据已经辨明全部原因。
另一条人物线处理的是“选择”。贾兹因担心长途乘车的时间和安全,选了步行可达、课程机会较少的学校;卡莱布则把出门时间提前,以换取赶上首节课的可能。人物在这里说明的,是制度选择怎样落到家庭可承受的路线。
先把抱怨变成可检验的问题
学生说车久等、衔接会断、应用预报不准。团队没有把这些口述直接当成全市结论,而是分成两个问题:在时刻表完全兑现时,学生理论上要走多久;在上学和放学时段,车辆实际有多常偏离计划。
第一个问题对应路线模型。通过公开记录请求,团队获得按居住普查区和就读学校汇总、已匿名化的数据:2023—2024学年共有4,210个“普查区—学校”组合,涉及最多约2.5万名学生的通勤需求。
这不是每位学生的住址或实际轨迹。它是把同一普查区去同一学校的学生作为一类路线需求,因此适合回答城市层面的通勤条件,不适合断言某一名学生每天究竟怎样走。
团队用r5模型,结合道路网络、公交时刻表、地铁和轻轨线路,为每个组合寻找最快公共交通路线。它以10分钟间隔倒推最晚出发时刻,目标是在校门开放铃前至少5分钟抵达,再按每个组合涉及的学生数加权汇总。
由此得出的“约40分钟平均通勤”和“近六成需要换乘”,描述的是最顺利情形下的系统结构。模型优先速度,不按安全感、直达程度或学生偏好挑选“最真实”的路线;学生也可能选择较慢但更可控的走法。
普查区只提供到街区量级的位置。团队以人口分布选取代表性起点,并排除公园、学校和工业区;这保护了学生隐私,却使同一普查区内不同住址的差异无法进入模型。
再用实际车辆检验时刻表
第二个问题不能由路线模型回答。团队从开学到1月中旬,每天凌晨4时至午夜每5秒抓取一次MTA公交实时位置,并保存每日计划时刻,形成数千万条记录。
他们把计划与实时记录按线路、班次、日期和站点连接,重点计算早晨5时至9时、下午2时至4时的准点率与发车间隔。这个时段选择直接对应学生上下学,而不是把全天平均表现拿来替代。
按MTA的定义,车辆在计划时间前2分钟至后7分钟到站都算准点。原作发现,学生早晨通勤时约四分之一车辆不在这个窗口内;下午约三分之一不在窗口内。
报道没有把这一口径当成唯一标准。若采用较窄的“前1分钟至后5分钟”窗口,早晨准点率为62%,下午为52%。两个数字共同说明:结论会随定义变化,而固定上课铃下的学生对短暂延误尤其敏感。
实时数据还留下约一成计划班次没有位置记录的“幽灵公交”。它们可能是取消班次,也可能是定位设备未传输。正文中的准点率只计算观察到的车辆;公开复算说明同时给出乐观和悲观上下界,真实值在两者之间且会随日变化。
这种限制很关键:数据可以显示已观测车辆与时刻表的偏差,不能凭缺失定位就断言每一辆未显示的车都没来。团队还因接口使用限制,只持续追踪了公交实时数据,没有以同样频率追踪地铁和轻轨。
两张图,两个提问
主稿的学校与全市对照图服务于编辑判断。读者选定一所学校后,可看该校模型路线数量、平均时间、距离和换乘比例,再与全市平均比较,因而能分辨一所学校的问题是特殊还是城市结构的一部分。
以巴尔的摩理工学院为例,图表显示1,580名学生可能对应191条独特路线;该校模型平均通勤41.4分钟,全市为39.1分钟。这些是学校层面的聚合估计,不是对每名学生实际出行的追踪。
家庭路线比较工具回答的则是另一件事:从同一出发点去不同学校,哪条早晨路线更短、换乘更少,且各段车次的准点率和下一班等待时间如何。它把报道中的城市分析转成选校时可查看的条件。
工具允许先生成A路线,再增加B学校并保留A路线并列比较;地图和分段卡片同时呈现步行、线路、车上时间与等候信息。它提示读者关注准点率和班距,却不能保证显示路线就是学生最终会采用的路线。
因此,两类互动不能互相替代。学校图用于发现结构性差异,路线工具用于比较一个家庭的备选方案;前者不提供个人化建议,后者也不能替代对运力、缺班和全市不平等的报道。
把反驳留在证据旁
原作保留了MTA的异议:机构称部分运力估计未反映实际乘客量,其传感器和手机数据在某些线路显示乘客少数百人。报道的回应是,分析采用学区规划校车时的逻辑:应有足够空间覆盖住在步行范围外、具备乘车资格的学生。
MTA还说,受联邦拨款条件限制,不能专设学生公交线,且要兼顾所有乘客;该机构已在上学日调整185辆车停靠学校,并设专人协调。学区负责人承认学校也有责任,但称全面改用黄色校车的成本难以承受。
这些回应没有推翻数据发现,却划出责任与方案的争议所在:车是否足够、谁应承担接送义务、怎样补足线路,都不能仅靠准点率数字回答。记者把相反解释放回同一问题,读者才能判断结论的适用范围。
可迁移的报道做法
能力一:把经历拆成测量问题。
场景:多名受访者说公共服务“不可靠”。判断:先区分“理论条件是否已不合理”与“实际运行偏差有多大”。动作:分别设计路线、等待、准点和运力指标。成果:一张指标与数据来源对照表。完成标志:每项投诉都有可证伪的对应问题。
能力二:让模型只回答它能回答的事。
场景:住址等敏感数据只能取得聚合版本。判断:代表性起点和最快路线只能估计条件,不能替代个人轨迹。动作:记录起点选取、权重、出发时间和路线偏好。成果:可复算的参数说明与限制段。完成标志:读者能区分估计、观察和个案。
能力三:为关键指标准备替代口径。
场景:机构的准点窗口较宽,而用户有固定到达时间。判断:不能把一种定义包装成自然事实。动作:同时计算机构口径与合理的较窄窗口,并说明差异。成果:口径比较表和解释文字。完成标志:结论在不同口径下的变化清楚可见。
能力四:把互动设计成报道的一部分。
场景:调查结果会影响家庭选校。判断:全市发现和个人选择需要不同界面。动作:用学校对照图呈现结构,用同起点的路线卡呈现选择条件。成果:两个问题明确、边界清楚的互动页面。完成标志:用户不会把演算结果误认成实时承诺或个人事实。
这套做法的成本不低:需要公开记录请求、路线建模能力、长期抓取与清洗数据、存储空间和对交通口径的核对;公开仓库说明,完整复算数据约需40GB,原始公交位置数据约需350GB,还需外部数据接口密钥。
隐私成本同样不能后置处理。原作以普查区而非家庭住址建模;家庭路线工具让读者比较从所在社区前往不同学校的路线,但这不等于掌握任何学生的实际住址或日常轨迹。对涉及未成年人的路线报道,先决定最小必要定位精度,往往比后来遮盖细节更可靠。
IRE于2026年公布的记录确认,该作品获2025年Philip Meyer Journalism Award一等奖。这一记录可确认奖项与作品范围;作品本身的事实、方法和限制,仍应回到原作、方法页、互动与公开复算说明核对。
方法提要
全市选校与小学后校车缺位叠加,使许多学生必须依赖与所有乘客共用的公共交通上学。
路线模型只描述最顺利情形:典型学生单程约40分钟,近六成至少换乘一次;它不是个人实际轨迹。
公交准点率会随定义变化,约一成计划班次又缺少实时位置记录;报道把口径和缺失值留在结论旁。